1引言
机器学习(MachineLearning)是人工智能(AI)的重要组成部分,目前已广泛应用于数据挖掘、自然语言处理、信用卡欺诈检测、证券市场分析等领域。量化投资作为机器学习在投资领域内最典型的应用之一,已经越来越广泛的出现在我们的视野中。
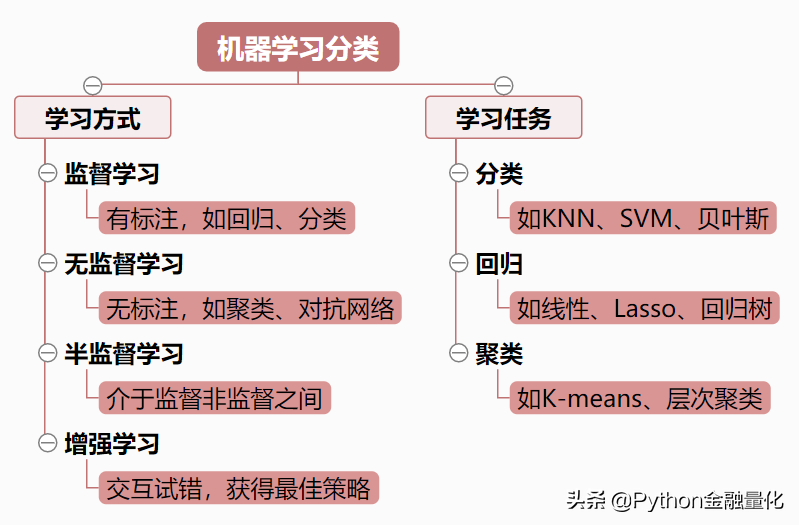
机器学习可简单理解为利用统计模型或算法拟合样本数据并进行预测,其模型算法根据学习任务可以分为分类、回归和聚类。分类方法是对离散型随机变量建模或预测的监督学习方法。分类是按照某种标准给对象贴标签,再根据标签来区分归类。而所谓的学习,其本质就是找到特征与标签间的关系(mapping即映射)。换句话说,分类预测模型是一个从输入特征到离散的输出标签之间的映射函数。分类方法常用的有朴素贝叶斯、分类树、支持向量机、KNN、集成学习(包括随机森林)和深度学习等。
股票指数涨跌的预测本质上是一个分类问题。机器算法有很多种,没有最好的模型,只有更适合解决当前问题的算法。当然,本文的目的不是寻找最优的算法,而是机器学习在分析预测的应用。基于此,本文以Logistic回归(LR)、线性判别法(LDA)、二次判别分析(QDA)模型为例,对上证综指的涨跌进行预测。后续推文将会应用其他可能更有效的算法,包括SVM、集成学习和深度学习等。
逻辑回归(LR)
逻辑回归(LogisticRegression,LR)是广义线性回归分析模型之一,其本质属于分类问题,因此主要用于被解释变量为分类(离散,如0,1)变量的情形。在分类问题上,逻辑回归要优于线性回归,因为线性回归在拟合被解释变量为离散时会出现负概率的情况,会导致错误的样本分类。而逻辑回归采用对数函数将预测范围压缩到0与1之间,从而提升预测准确率。
假设L1,L2,…Ln为预测因子,LR模型使用对数公式对上涨(U)的条件概率建立以下模型:
一般使用最大似然法来拟合上述模型。关于逻辑回归的详细推导此处不再展开,想进一步了解的可以找本计量经济学入门教材学习(如伍德里奇的《计量经济学导论》)。机器学习库scikit-learn提供了估计模型的“黑盒子”。
线性判别法(LDA)
线性判别分析,全称LinearDiscriminantAnalysis(LDA)与LR的区别在于,LR使用对数函数将P(Y=U|L1,L2,,Ln)建模为给定预测变量Li的响应Y的条件分布;在LDA中,给定Y,分别对Li变量的分布进行建模,并通过贝叶斯定理获得P(Y=U|L1,L2,,Ln)。
本质上,LDA是通过假设预测变量来自多元高斯分布得出的。在计算出该分布的参数的估计值之后,可以将这些参数输入贝叶斯定理中,以便对观测值属于哪个类别做出预测。LDA假定所有类别共享相同的协方差矩阵。由于scikit-learn提供了拟合和预测方法,所以不用太担心对预测所需的分布或后验概率的公式不了解。
二次判别分析(QDA)
二次判别分析,英文全称是QuadraticDiscriminantAnalysis(QDA),与LDA密切相关。二者的区别在于,QDA的每个类别都可以拥有自己的协方差矩阵。当决策边界为非线性时,QDA通常会表现更好。LDA通常在训练观察次数较少时(即需要减少方差时)表现更好。另一方面,当训练集较大时(即,差异较小,则QDA表现良好)。一个或另一个的使用最终归结为偏差方差的权衡。与LR和LDA一样,scikit-learn提供了QDA的实现函数,因此我们只需要提供训练/测试数据即可进行参数估计和预测。
3预测步骤预测主要分为三个步骤:
第一,根据上证综指指数收益率的正负划分为上涨(1)和下跌(-1)两种类型,作为被解释变量。
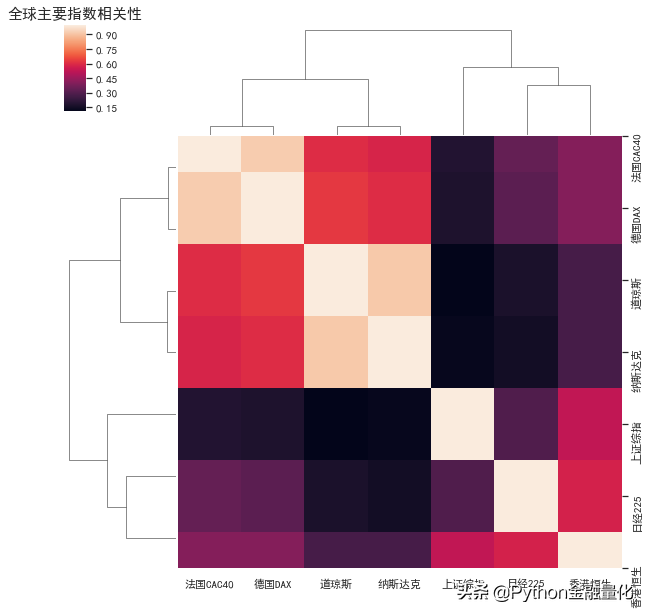
第二,寻找合适预测因子。预测因子的选择,与预测方法的选择一样重要,对预测性能起到决定性作用。预测股市指数回报时,有很多潜在因素可供选择,并且有可用的统计检验可以证明每个因子的预测能力。但是本文的目的是为了展示预测的过程而非结果,因此在因子选择上不会作过多的分析。考虑到全球资本市场联系越来越紧密,本文使用全球几大主要指数(如道琼斯、日经225、德国DAX指数等)以及上证综指自身的滞后值作为预测因子。
4Python实现代码正常显示画图时出现的中文和负号['']=['SimHei']['_minus']=False
获取数据
importdatetimeimportyfinanceasyfdefget_data(stocks,start_date,_date):'''stocks为股票代码和简称字典'''data=()forcode,():dd=(code)data[name]=(start=start_date,=_date)['Close']data=[2:,:].fillna(method='ffill')returndataStockIndexs={'000001.SS':'上证综指','^DJI':'道琼斯','^IXIC':'纳斯达克','^N225':'日经225','^HSI':'香港恒生','^FCHI':'法国CAC40','^GDAXI':'德国DAX'}累计收益率(data/[0]).plot(figsize=(14,6))('全球主要指数累计净值\n(2008-2019)',size=15)()上涨用1表示,下跌(含0)为-1df['direction']=(ret['上证综指'].values0,1.0,-1.0)
df=()
returndf
Fitandpredictthemodelonthetraining,andthentest,(X_train,y_train)pred[name]=(X_test)获取数据variables=get_variables(ret).loc[:'2017']把原始数据的40%作为测试数据,其余为训练数据以2017年以前数据为训练集,2017年数据为测试集start_test=(2017,1,1)X_train=X[_test]X_test=X[=start_test]y_train=y[_test]y_test=y[=start_test]分别拟合LR,LDA和QDA三个模型print("预测准确率:")models=[("LR",LogisticRegression(solver='liblinear')),("LDA",LDA()),("QDA",QDA())]forminmodels:fit_model(m[0],m[1],X_train,y_train,X_test,pred)预测准确率:LR模型:0.557LDA模型:0.566QDA模型:0.590从模型的预测准确率来看,并不是很理想,三个模型中使用QDA的效果要好一些(可能因为训练数据集样本较多,而测试集分配较少),准确率也只有0.59,只比投掷硬币好一丁点。下面以QDA模型为例,使用混淆矩阵和ROC曲线对模型的预测性能作进一步评价,混淆矩阵图没有给出,ROC曲线图很直观,此处不过多分析。
model=QDA()
(X_train,y_train)
构建混淆矩阵
cm=(y_test,pred)
cm
(cm,annot=True,cmap='GnBu',fmt='d')
print('模型的准确率为:\n',accuracy_score(y_test,pred))print('模型的评估报告:\n',classification_report(y_test,pred))模型的准确率为:0.59016模型的评估报告:fpr表示1-Specificity,tpr表示Sensitivity
fpr,tpr,threshold=roc_curve(y_test,y_score)
绘制面积图
(figsize=(8,6))
(fpr,tpr,color='steelblue',alpha=0.5,edgecolor='black')
(fpr,tpr,color='black',lw=1)
添加文本信息
(0.5,0.3,'ROC曲线(area=%0.2f)'%roc_auc)
#添加x轴与y轴标签
('QDA模型预测指数涨跌的ROC曲线',size=15)
('1-Specificity')
('Sensitivity')
()
5结语本文主要以逻辑回归(LR)、线性判别分析(LDR)、二次线性判别分析(QDR)为例,展示了机器学习算法在股价涨跌预测上的应用。模型预测效果不甚理想,并不代表机器学习算法的失效,主要原因可能是没有选择好合适的预测的因子,关于什么样的因子才是预测股指涨跌的最好因素留待读者自己去挖掘(这也是量化研究者孜孜不倦在追求的)。
关于Python金融量化
参考资料:
1.scikit-learn官网:
2.ForecastingFinancialTimeSeries-PartI
3.雅虎数据API: